EU AI Act: Artikel 15
Bedeutung
Hochrisiko-KI muss nachweislich robust gegen Adversarial Attacks sein. GPAI-Governance seit August 2025. EU AI Act im Überblick
KI-Penetrationstest
Prompt Injection. Jailbreaking. Datenexfiltration. Wir testen Ihre LLMs, RAG-Systeme und KI-Agenten so, wie echte Angreifer es tun, nach OWASP Top 10 LLM und MITRE ATLAS.
Vertrauen unserer Kunden
Das Problem
Ihr LLM-Chatbot, Ihr KI-Copilot, Ihre automatisierte Entscheidungslogik: sie alle haben eine Angriffsfläche, die kein klassischer Penetrationstest abdeckt. Prompt Injection allein betrifft jede LLM-Anwendung. Und die regulatorische Uhr tickt:
EU AI Act: Artikel 15
Bedeutung
Hochrisiko-KI muss nachweislich robust gegen Adversarial Attacks sein. GPAI-Governance seit August 2025. EU AI Act im Überblick
NIS-2 & DORA
Bedeutung
KI-gestützte Systeme in KRITIS und Finanzwesen unterliegen Sicherheitsprüfpflichten, mit persönlicher Geschäftsführerhaftung.
DSGVO-Risiko
Bedeutung
LLMs können trainierte Personendaten preisgeben. Ein einziger Data-Leakage-Vorfall kann Bußgelder und Reputationsschaden verursachen.
KLASSISCHER PENTEST
Testet Netzwerke, APIs, Web-Apps, Infrastruktur, aber nicht die KI-Logik, das Modellverhalten oder die Guardrails.
KI-PENETRATIONSTEST
Testet zusätzlich: Prompt Injection, Jailbreaking, Datenexfiltration, Guardrail-Bypass, Agentenverhalten, Modellintegrität, RAG-Poisoning.
Testbereiche
Sechs spezialisierte Testbereiche, individuell auf Ihre KI-Architektur zugeschnitten.
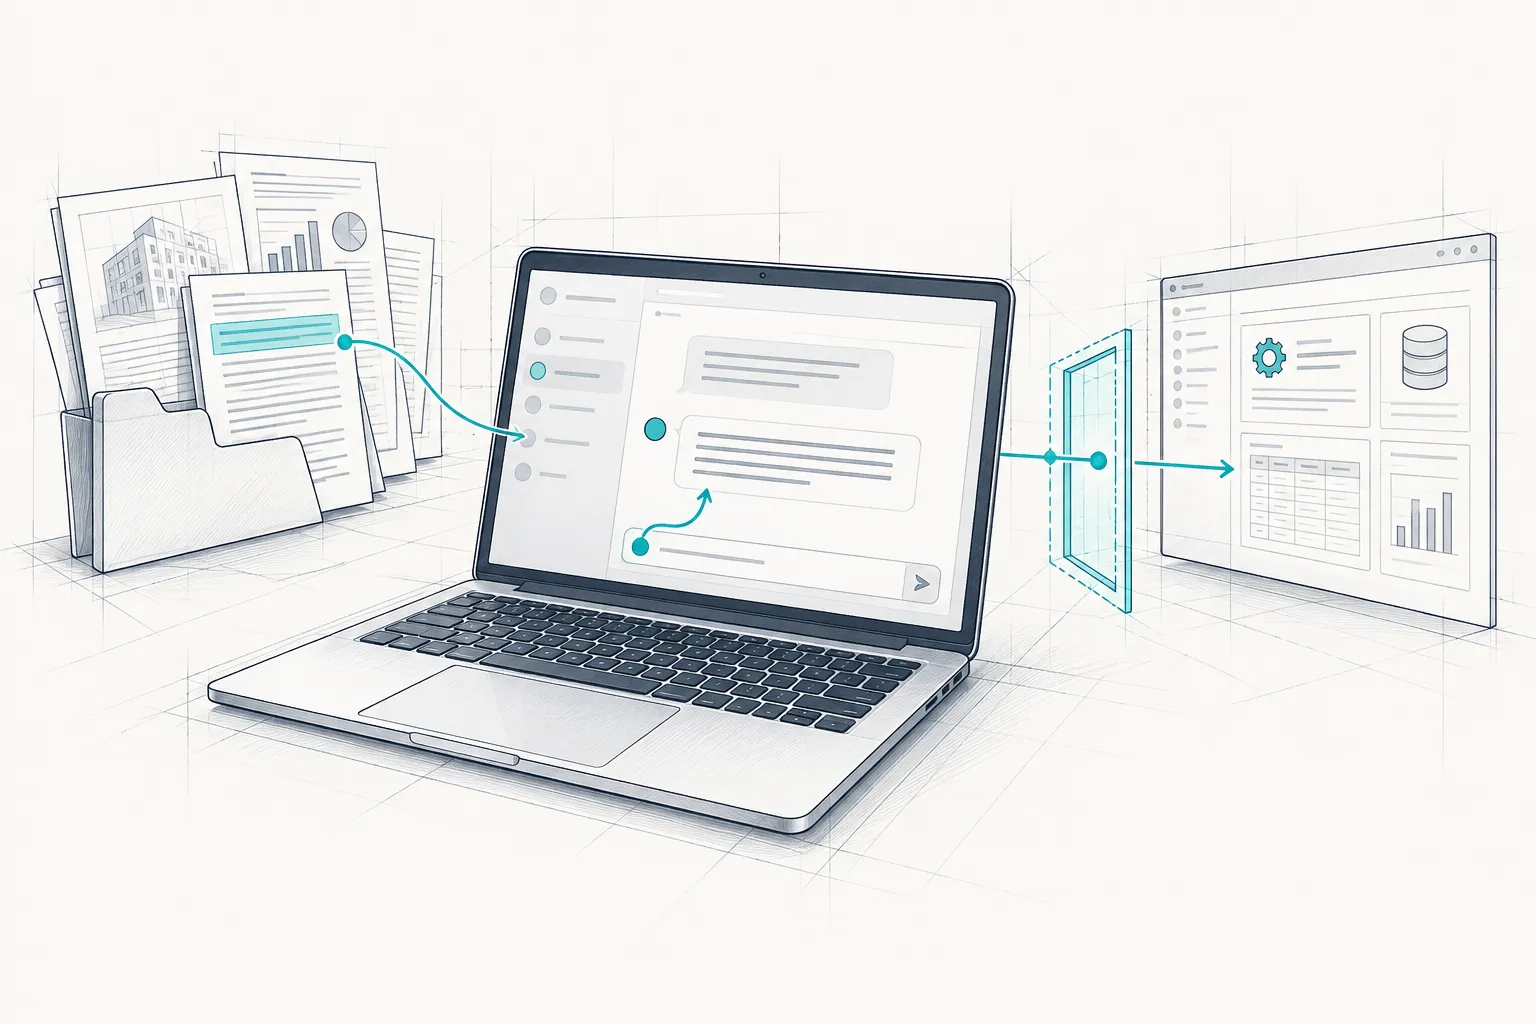
Beispiel einer KI-Anwendung. Welche Komponenten wir prüfen, legen wir gemeinsam im Scope fest.
Bei Chatbots, Copiloten und KI-Assistenten prüfen wir direkte und indirekte Prompt Injection, Jailbreaking, System-Prompt-Extraktion, Datenexfiltration und Hallucination Exploitation.
Für Modelle wie GPT, Claude und Llama, entlang der OWASP Top 10 für LLMs.
Wir untersuchen Document Poisoning, Manipulationen an Vektordatenbank und Retrieval sowie kontextuelle Prompt Injection über eingespeiste Dokumente und Datenquellen.
Bei Agenten mit Werkzeugzugriff testen wir Tool-Missbrauch, Privilege Escalation, Denial-of-Wallet, Multi-Step-Exploitation und Memory-Manipulation.
Dazu gehören Tool Use und MCP; OWASP LLM06 ist eine der Prüfgrundlagen.
Wir prüfen Content-Filter, Jailbreak-Detektoren, PII-Masking und Output-Validatoren auf Umgehungsmöglichkeiten. Bypass-Raten sowie False Positives und False Negatives machen die Effektivität messbar.
Für klassische ML-Systeme in Fraud Detection, Scoring und Diagnostik prüfen wir Adversarial Examples, Data Poisoning, Model Inversion, Membership Inference und Modelldiebstahl.
Orientierung bieten die OWASP ML Top 10 und MITRE ATLAS.
Wir prüfen MLOps-Pipelines, den Zugriff auf Model Registries, API-Endpunkte, die Integrität der Daten-Pipeline und die Supply Chain eingesetzter Modelle.
Methodik
2-3 Tage
Identifikation aller KI-Komponenten, Bedrohungsmodellierung nach MITRE ATLAS, Definition der Rules of Engagement und des Testumfangs.
3-5 Tage
Analyse der KI-Architektur: Modell-Endpunkte, API-Schnittstellen, Daten-Pipelines, Guardrail-Konfiguration, Agenten-Fähigkeiten und Integrationen.
5-10 Tage
Automatisierte Scans (Garak, Promptfoo) kombiniert mit manueller Expertenanalyse. Systematische Prüfung aller OWASP-Top-10-LLM-Kategorien und MITRE-ATLAS-Techniken.
2-5 Tage
Bestätigung kritischer Findings mit Proof-of-Concept. Verkettung von Schwachstellen zu realistischen Angriffsszenarien mit quantifiziertem Business Impact.
2-4 Tage
Technischer Bericht mit CVSS-Scoring, Compliance-Mapping (OWASP, EU AI Act, ISO 42001, NIST AI RMF) und priorisierter Remediation-Roadmap. Management Summary und Abschlusspräsentation.
Typische Gesamtdauer: 15-25 Tage - abhängig von Scope und Anzahl der KI-Komponenten.
Sie erhalten innerhalb von 48 Stunden (werktags) ein verbindliches Festpreisangebot.
Datensouveränität
System-Prompts, Trainingsdaten und Gesprächsprotokolle sind oft das wertvollste Asset eines KI-Systems. Beim Test behandeln wir sie entsprechend.
Architektur, System-Prompts und Guardrail-Konfigurationen Ihres KI-Systems verlassen unsere eigene Hardware in Deutschland nicht.
Wissensbasen und Embeddings, die wir im Test einsehen, werden mit lokal betriebenen Open-Source-Modellen analysiert - keine externen KI-Dienste.
Testprotokolle und Angriffs-Prompts liegen vom ersten Test bis zum Abschlussbericht auf unseren eigenen Servern in Deutschland.
Verbindlich zugesichert in unserer Auftragsverarbeitung (TOMs): Keine fremden KI-Dienste für Aufgaben, die Kunden- oder Auftraggeberdaten verarbeiten. Mehr zur digitalen Souveränität
Compliance
Jedes Finding wird auf die relevanten Standards gemappt. Ihr Bericht ist audit-ready.
Systematische Prüfung aller 10 Schwachstellenkategorien für LLM-Anwendungen. Der Katalog ist der De-facto-Standard für LLM-Security.
Internationale Community · Open Source
Bedrohungsmodellierung und Angriffsszenarien nach dem KI-spezifischen Pendant zu MITRE ATT&CK.
Taktiken · Techniken · Verfahren
Nachweis der Anforderungen aus Artikel 15: Genauigkeit, Robustheit, Cybersicherheit für Hochrisiko-KI.
Art. 15 · GPAI seit Aug. 2025
Technische Evidenz für die Controls des KI-Managementsystem-Standards, Grundlage für Zertifizierung.
38 Controls · 9 Ziele
Mapping auf die vier Kernfunktionen Govern, Map, Measure, Manage des AI Risk Management Frameworks.
Inkl. GenAI Profile (2024)
Integration in bestehende BSI-IT-Grundschutz-Dokumentation und NIS-2-Sicherheitsanforderungen.
KRITIS · § 31 BSIG
Pakete
Festpreisangebote innerhalb von 48 Stunden (werktags). Keine Stundensätze, keine Nachforderungen.
FOKUSSIERT
Einzelner Chatbot oder Copilot
ab 8.100 € zzgl. MwSt. · ab 9.639 € brutto
UMFASSEND
EmpfohlenMehrere KI-Komponenten + RAG
ab 14.850 € zzgl. MwSt. · ab 17.671,50 € brutto
PREMIUM
Adversariale Simulation · 4-6 Wochen
ab 25.650 € zzgl. MwSt. · ab 30.523,50 € brutto
Warum AWARE7
Reine Awareness-Plattformen testen keine Systeme. Reine Beratungskonzerne sind zu weit weg. AWARE7 verbindet beides: Wir hacken Ihre Infrastruktur und schulen Ihre Mitarbeiter: mittelstandsgerecht, persönlich, ohne Enterprise-Overhead.
Rund 20% unseres Umsatzes stammen aus Forschungsprojekten für BSI und BMBF. Unsere auf ACM- und Springer-Konferenzen publizierten Studien analysieren Millionen von Websites und Zehntausende Phishing-E-Mails. Drei unserer Führungskräfte sind gleichzeitig Professoren an deutschen Hochschulen.
Ihre Daten liegen vom Erstkontakt bis zum Abschlussbericht auf unseren eigenen Servern in Deutschland - ohne US-Cloud-Anbieter, ohne Drittlandtransfer. Auch unsere KI läuft auf eigener Hardware in Deutschland - mit lokal betriebenen Open-Source-Modellen. Kunden- und Auftraggeberdaten erreichen keine externen KI-Dienste. Alle Mitarbeiter sind festangestellt, sozialversicherungspflichtig und einheitlich rechtlich verpflichtet.
Mehr zur digitalen SouveränitätInnerhalb von 24 Stunden erhalten Sie ein verbindliches Festpreisangebot ohne Stundensatz-Risiko. Eingespieltes Team und standardisierte Prozesse sorgen für einen klaren Zeitplan mit definiertem Start- und Endtermin.
Ein persönlicher Projektleiter begleitet Sie vom Erstgespräch bis zum Re-Test. Sie buchen Termine direkt bei Ihrem Ansprechpartner und behalten dieselbe Kontaktperson über das gesamte Projekt.
Für wen sind wir der richtige Partner?
Mittelstand mit 50-2.000 MA
Unternehmen, die echte Security brauchen, ohne einen DAX-Konzern-Dienstleister zu bezahlen. Festpreis, klarer Scope, ein Ansprechpartner.
IT-Verantwortliche & CISOs
Die intern überzeugend argumentieren müssen und dafür einen Bericht mit Vorstandssprache brauchen, nicht nur technische Findings.
Regulierte Branchen
KRITIS, Gesundheitswesen, Finanzdienstleister: NIS-2, ISO 27001, DORA. Wir kennen die Anforderungen und liefern Nachweise, die Auditoren akzeptieren.
Peer-reviewte Publikationen
Different Seas, Different Phishes - Large-Scale Analysis of Phishing Simulations
ACM AsiaCCS 2025
Oskar Braun, Jan Hörnemann, Norbert Pohlmann, Matteo Große-Kampmann
A Platform for Physiological and Behavioral Security
NSPW 2025
Jan Hörnemann
Privacy from 5 PM to 6 AM: Tracking and Transparency in the HbbTV Ecosystem
IEEE/IFIP DSN 2025
Jan Hörnemann, Norbert Pohlmann, Matteo Große-Kampmann
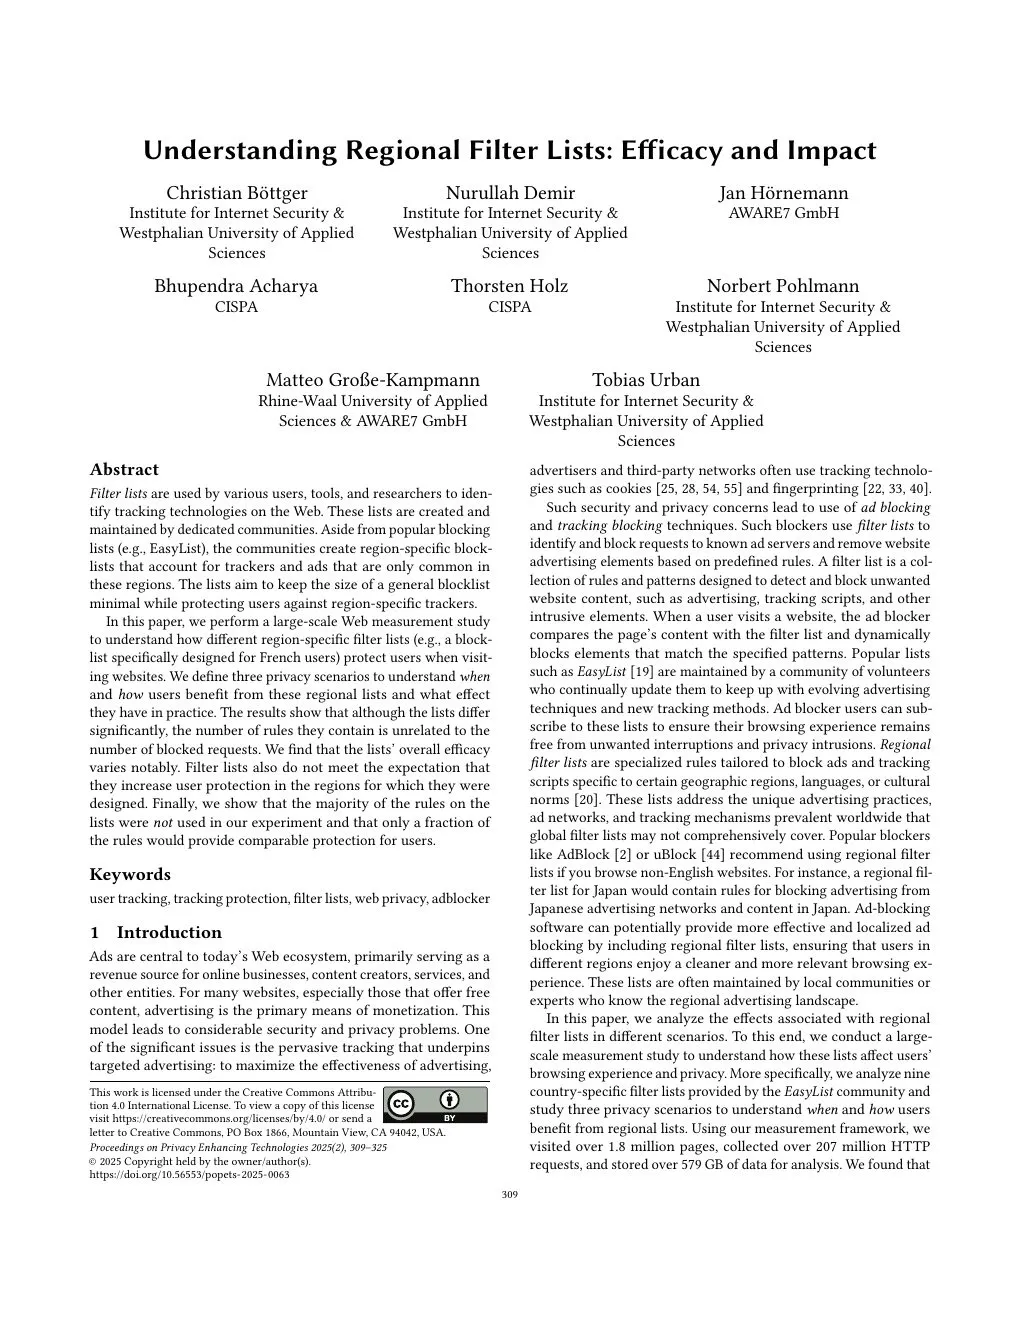
Understanding Regional Filter Lists: Efficacy and Impact
PoPETS 2025
Jan Hörnemann, Norbert Pohlmann, Matteo Große-Kampmann
Referenzen
Alles, was Sie vor dem Erstgespräch wissen sollten.
Aus dem Blog
KI-Compliance: Der OWASP GenAI Crosswalk ordnet 51 KI-Risiken den Controls aus 25 Regelwerken zu. ISO 42001, DORA und die EU-KI-VO decken je 41 davon ab.
 Jan Hörnemann
Privilege Escalation wird häufig für das Nachladen von Schadsoftware benötigt. In einem aktuellen Fall reicht bereits eine Razer-Maus aus!
 Chris Wojzechowski
Penetrationstest vs. Red Team: Unterschiede bei Scope, Tiefe, Dauer und Ziel - wann welche Methode sinnvoll ist und was ein Red Team leistet.
 Vincent Heinen
Unsere Experten prüfen Ihre LLMs, RAG-Systeme und KI-Agenten, mit Festpreiszusage und audit-ready Reporting.
Kostenlos · 30 Minuten · Unverbindlich

Arturs Nikitins
Erstberatung & Bedarfsanalyse
Persönliche Beratung gewünscht?
Unverbindlich · Antwort werktags innerhalb 24h
